Español
 English
 Français
 Português
 Deutsch
 Italiano
Wie man Machine-Learning-Modelle stabil in Produktion bringt: Der Leitfaden zum Live-Workshop von Hadelin de Ponteves
 KI-generiert
In der modernen Technologiewelt existiert eine alarmierende Diskrepanz: Unternehmen investieren beträchtliche Budgets in Data-Science-Teams, um moderne Machine-Learning-Modelle zu entwickeln – doch über 80 % dieser Modelle schaffen niemals den Sprung in den produktiven Dauereinsatz. Und selbst unter den wenigen Systemen, die den Live-Betrieb erreichen, erleidet mehr als die Hälfte bereits in den ersten Wochen unbemerkte Leistungseinbrüche, gravierende Genauigkeitsverluste und unkalkulierbare Betriebskosten.
Die Ursache für dieses Scheitern liegt selten in der mathematischen Eleganz der Algorithmen. Das eigentliche Kernproblem besteht darin, dass die Entwicklung in einem isolierten Experimentierfeld (wie einem Jupyter-Notebook) völlig anderen Gesetzen folgt als der Betrieb in einer hochverfügbaren Unternehmenssoftware, die tausende Anfragen pro Sekunde verlässlich beantworten und sich dynamischen Marktbedingungen anpassen muss.
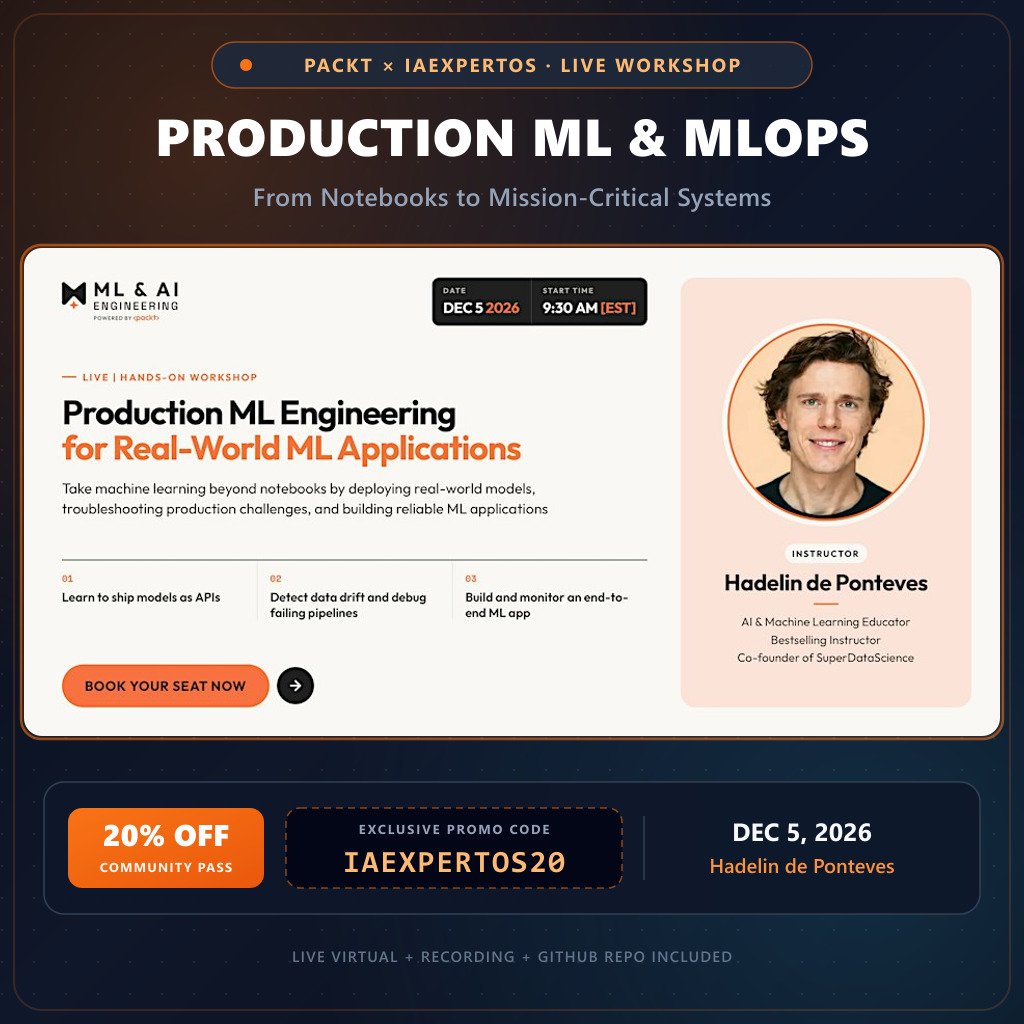
Um diesen strategischen Graben endgültig zu schließen, veranstaltet der renommierte Fachverlag Packt am 5. Dezember 2026 einen exklusiven interaktiven Live-Technik-Workshop: „Production ML Engineering for Real-World ML Applications“, geleitet von Hadelin de Ponteves, einer weltweit anerkannten Führungspersönlichkeit in der angewandten KI-Ausbildung und Bestsellerautor mit über 2,5 Millionen geschulten Ingenieuren.
Für Leser und Mitglieder der IAExpertos-Community gibt es einen direkten Preisvorteil: 20% Rabatt mit dem Aktionscode IAEXPERTOS20, wodurch der offizielle Eventbrite-Preis von 215,25 USD auf günstige 172,20 USD sinkt.
In diesem Leitfaden erfahren Sie verständlich, praxisbezogen und fokussiert auf unternehmerische Mehrwerte, welche Grundlagen Sie in diesem Training meistern und warum diese Fähigkeiten für jeden Software-Ingenieur und IT-Entscheider unverzichtbar sind.
1. Die verborgenen technischen Schulden: Warum ein Notebook kein Softwareprodukt ist
Wenn ein Data-Science-Team eine Genauigkeit von 95 % auf historischen Testdaten erzielt, beginnt die eigentliche Ingenieursarbeit erst. Wie Google in einer wegweisenden Studie über technische Schulden im Machine Learning aufzeigte, macht der eigentliche Modellcode weniger als 5 % des Gesamtsystems aus. Die restlichen 95 % entfallen auf die unterstützende Infrastruktur:
- Abhängigkeits- und Umgebungskonflikte: Software-Setups, die auf einem lokalen Entwickler-Laptop einwandfrei laufen, führen auf Cloud-Servern häufig zu unvorhergesehenen Inkompatibilitäten.
- Diskrepanzen zwischen Training und Inferenz (Skew): Die Art und Weise, wie Daten für das Training bereinigt wurden, weicht in der Praxis oft von den Live-Datenströmen ab, was vom ersten Tag an zu fehlerhaften Vorhersagen führt.
- Blindheit herkömmlicher Server-Überwachung: Standard-Metriken wie CPU-Last oder schnelle HTTP-Antwortzeiten bemerken nicht, wenn ein Modell plötzlich unbrauchbare Empfehlungen ausgibt, weil sich das Kundenverhalten gewandelt hat.
Goldene Regel im Produktivbetrieb:
Ein Modell, das in 10 Millisekunden antwortet, aber falsche Entscheidungen trifft, ist weitaus gefährlicher als ein abgestürzter Server, da es unbemerkt wirtschaftlichen Schaden anrichtet.
2. Die lautlosen Risiken: Data Drift und Concept Drift verständlich erklärt
Exklusive Tech-Angebote auf Amazon
Algorithmen unterliegen keinem physischen Verschleiß, dennoch altern sie unweigerlich durch Veränderungen im realen Marktumfeld:
- Daten-Verschiebung (Data Drift): Tritt auf, wenn sich die statistische Zusammensetzung der Nutzerdaten verändert. Wurde ein Kreditprüfungsmodell beispielsweise in Niedrigzinsphasen mit 1 % Zinsen trainiert und die Wirtschaft steigt auf 5 % Zinsen, treffen völlig andere Eingabewerte ein, als dem Modell bekannt sind.
- Konzept-Verschiebung (Concept Drift): Entsteht, wenn sich das Verhalten der Menschen grundlegend ändert. Während ökonomischer Umbrüche wandeln sich Einkaufsgewohnheiten innerhalb kürzester Zeit; ein Modell, das Verkaufszahlen auf Basis historischer Daten prognostiziert, liegt plötzlich massiv daneben.
Anschauliche Formel für den Population Stability Index (PSI):
Alarmstufe = Summe aus [ (Aktueller Anteil % - Basis-Anteil %) x Logarithmische Differenz ]
Klar und verständlich auf den Punkt gebracht:
- Liegt der Wert unter 0,10, verhält sich die Nutzerschaft stabil und das Modell arbeitet zuverlässig.
- Zwischen 0,10 und 0,25 zeigen sich moderate Veränderungen, die eine Prüfung nahelegen.
- Übersteigt der Wert 0,25, hat sich das Umfeld kritisch verschoben und das Modell muss umgehend neu trainiert oder abgesichert werden.
Im Workshop von Hadelin de Ponteves lernen Sie, automatische Frühwarnsysteme einzurichten, die diese Kennzahlen kontinuierlich überwachen und Alarm schlagen, bevor geschäftliche Einbußen entstehen.
3. Sichere Deployment-Strategien: Schluss mit riskanten Rollouts
In der klassischen Webentwicklung ist das Einspielen eines Updates ein standardisierter Schritt. Im Machine Learning ist es jedoch hochgradig riskant, ein neues Modell sofort auf 100 % der Live-Nutzer loszulassen.
Im Kurs lernen Sie die zwei wichtigsten Bereitstellungsstrategien moderner Tech-Unternehmen:
- Schatten-Deployment (Shadow Deployment): Das neu entwickelte Modell erhält im Hintergrund eine Kopie aller Live-Anfragen, seine Antworten werden jedoch nicht an den Nutzer ausgespielt, sondern intern protokolliert. So lässt sich das System unter echter Last und mit realen Daten risikofrei testen.
- Stufenweise Canary-Releases: Hat sich das Modell im Schattenbetrieb bewährt, werden ihm zunächst 1 % bis 5 % der Nutzer zugewiesen. Bei stabilen Geschäftsergebnissen wird der Anteil schrittweise auf 25 %, 50 % und schließlich 100 % erhöht.
Unverzichtbare Sicherheitsarchitektur:
Jedes Produktionssystem benötigt einen automatischen Notfallschalter (Circuit Breaker), der bei Fehlerspitzen oder Latenzproblemen den Datenverkehr sekundenschnell auf das bewährte Vorgängermodell zurückleitet.
4. Kontinuierliches Retraining und industrielle Praxisszenarien
Ein Machine-Learning-Modell ist kein statisches Monument, das nach dem ersten Training unverändert bleibt. Der wahre Wert eines ML-Engineers besteht darin, automatisierte Feedback- und Re-Trainings-Pipelines zu etablieren:
- E-Commerce und Produktempfehlungen: Kataloge und Kundenpräferenzen in Echtzeit aktualisieren, um Konversionsraten ohne Serverüberlastung zu maximieren.
- Betrugserkennung im Finanzsektor: Schnelle Anpassung an neuartige Angriffsmuster bei gleichzeitiger Minimierung von Fehlalarmen für treue Kunden.
- Vorausschauende Wartung in der Industrie: Sensordaten auswerten, um mechanische Ausfälle rechtzeitig abzuwenden und teure Anlagenstillstände zu verhindern.
5. Strategische Architektur- und Kostenaspekte für Führungskräfte
Für IT-Leiter, Engineering Manager und CTOs geht es beim Deployment von Machine Learning vor allem um Planbarkeit, Stabilität und Investitionssicherheit:
- Effiziente Cloud-Ressourcennutzung und Kostendeckelung: Durch den gezielten Einsatz von Modellquantisierung, Caching-Strategien und elastischem Auto-Scaling lassen sich Infrastrukturkosten um bis zu 60 % senken, ohne Einbußen bei der Antwortgeschwindigkeit hinnehmen zu müssen.
- Revisionssicherheit und Nachvollziehbarkeit: Der Aufbau standardisierter Feature Stores und Metadaten-Repositories stellt sicher, dass jede historische Vorhersage jederzeit bis zum genauen Trainingsstand und den Ausgangsdaten auditiert werden kann – eine unverzichtbare Voraussetzung für regulatorische Compliance.
- Entkopplung für reibungslose Modell-Upgrades: Durch saubere REST- und gRPC-Schnittstellen zwischen der Inferenz-Schicht und den Anwendungen können Modelle im laufenden Betrieb ohne Ausfallzeiten für Endnutzer ausgetauscht werden.
Diese Vorgehensweise schützt Budgets und stellt sicher, dass Unternehmen agil auf technische Innovationen reagieren können.
6. Detaillierter Ablauf des Live-Schulungstages mit Hadelin de Ponteves
Der Workshop am 5. Dezember 2026 ist als praxisorientierte Intensiv-Masterclass konzipiert und gliedert sich in vier zielgerichtete Module:
- Modul 1 (Vom Notebook zur Microservice-Architektur): Wie man experimentelle Modelle sauber containerisiert (Docker) und als zustandslose Inferenz-Dienste mit FastAPI und Triton Inference Server aufsetzt.
- Modul 2 (Echtzeit-Drift-Erkennung in der Praxis): Konfiguration automatisierter Monitoring-Pipelines zur kontinuierlichen Messung von Population Stability Index (PSI) und statistischen Abweichungen ohne manuelle Eingriffe.
- Modul 3 (Stresstests, Canary-Rollouts und Rollbacks): Praktische Übung zur Einrichtung von Shadow Deployments und stufenweisen Verkehrsumleitungen mit automatischen Notfall-Abschaltungen.
- Modul 4 (Automatisierte Continuous-Training-Pipelines): Aufbau robuster Feedback-Schleifen zur kontrollierten Modell-Aktualisierung mit Human-in-the-Loop-Freigaben.
Alle Teilnehmer erhalten im Anschluss vollständigen Zugriff auf alle erarbeiteten Referenz-Repositories und Checklisten.
Fazit für die Praxis: Wer diese modularen Schritte konsequent implementiert, eliminiert das Risiko von Ausfallzeiten und sichert die langfristige Akzeptanz von KI-Initiativen im gesamten Unternehmen.
7. Warum sich die Teilnahme mit Hadelin de Ponteves auszahlt
Hadelin de Ponteves ist Mitbegründer von Bluelife AI und hat zahlreiche internationale Konzerne bei der rentablen Einführung von Machine-Learning-Lösungen begleitet.
- Anschauliche und praxisnahe Didaktik: Hadelin versteht es meisterhaft, komplexe Zusammenhänge verständlich zu erklären und auf praxistaugliche Softwarearchitekturen herunterzubrechen.
- Interaktiver Austausch: Stellen Sie Ihre konkreten Projektfragen direkt im Live-Workshop und sichern Sie sich dauerhaften Zugriff auf alle Schulungsunterlagen und Code-Repositories.
- Exklusiver IAExpertos-Vorteil: Mit dem Aktionscode IAEXPERTOS20 sparen Sie 43,05 USD und nehmen für nur 172,20 USD an diesem Spitzen-Workshop teil.
8. Fazit und Anmeldung
Die Zukunft erfolgreicher KI-Lösungen gehört nicht jenen, die isolierte Modelle in Notebooks bauen, sondern Ingenieuren, die deren zuverlässigen, sicheren und kosteneffizienten Dauerbetrieb garantieren.
Der Workshop „Production ML Engineering for Real-World ML Applications“ am 5. Dezember vermittelt genau diese gefragten Kernkompetenzen. Die Plätze sind begrenzt, um den direkten Austausch mit dem Referenten zu gewährleisten. Sichern Sie sich Ihr Ticket rechtzeitig mit 20% Rabatt.