Español
 English
 Français
 Português
 Deutsch
 Italiano
Comment Concevoir des Applications d'IA d'Entreprise Réellement Efficaces : Le Guide Pratique du Workshop de Brij Kishore Pandey
 Générée par IA
Le déploiement fulgurant de l'intelligence artificielle générative a placé les dirigeants d'entreprise face à une réalité incontournable : concevoir un prototype élémentaire à l'aide d'un grand modèle de langage ne demande qu'une après-midi, mais industrialiser cette solution avec une fiabilité absolue, une précision exemplaire et une maîtrise rigoureuse des coûts constitue l'un des défis d'ingénierie les plus ardus d'aujourd'hui. L'immense majorité des initiatives d'IA restent bloquées au stade de systèmes de recherche vectorielle simples qui renvoient des approximations, souffrent d'hallucinations aléatoires et manquent de métriques d'évaluation tangibles.
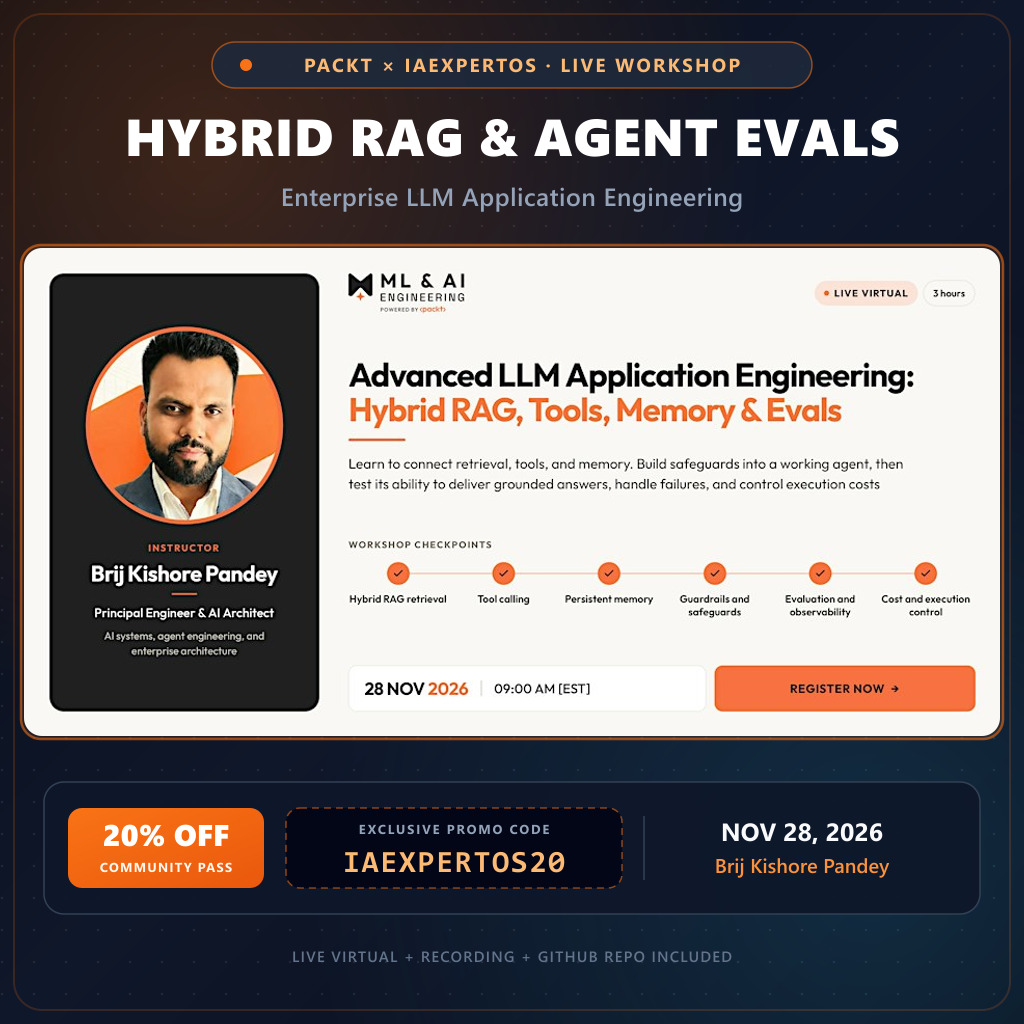
Pour surmonter ces obstacles et donner une impulsion décisive à votre carrière technique, la prestigieuse maison d'édition technologique Packt organise le 28 novembre 2026 un atelier technique en direct de premier plan : « Advanced LLM Application Engineering: Hybrid RAG, Tools, Memory & Evals », animé par Brij Kishore Pandey, architecte de systèmes IA de réputation internationale.
De plus, la communauté d'IAExpertos bénéficie d'une opportunité exclusive : une réduction immédiate de 20 % grâce au code promotionnel IAEXPERTOS20, ramenant le tarif d'inscription officiel de 215,25 dollars à seulement 172,20 dollars.
Dans ce dossier complet, nous expliquons de manière claire, pratique et sans verbiage inutile les compétences fondamentales que vous assimilerez durant cette formation intensive, et comment leur maîtrise vous hissera parmi les professionnels capables de bâtir des solutions d'IA d'entreprise rentables et pérennes.
1. Les Limites du RAG Naïf : Pourquoi la Recherche Vectorielle Seule Ne Suffit Plus
Durant les deux dernières années, la démarche standard pour connecter des documents professionnels à un modèle de langage consistait à utiliser la recherche vectorielle classique : découper les documents, calculer des coordonnées sémantiques (embeddings) et trouver les passages les plus proches par similarité géométrique.
Si cette méthode fonctionne pour des requêtes conceptuelles générales, elle échoue lourdement face aux exigences concrètes des entreprises :
- Incapacité à identifier les références précises : Lorsqu'un collaborateur recherche une référence exacte de contrat, un numéro de série ou un identifiant d'anomalie tel que ERR-409-CONFLICT, la recherche vectorielle cherche à deviner un concept abstrait au lieu de repérer la chaîne de caractères exacte, renvoyant des sections hors sujet.
- Vulnérabilité face aux négations : Une requête demandant les "accords commerciaux n'incluant aucune clause d'indemnité de rupture" désoriente fréquemment les index vectoriels, qui remontent en priorité les contrats mentionnant précisément ces indemnités.
- Absence de discernement contextuel et temporel : Deux extraits peuvent obtenir un score vectoriel similaire, alors que l'un est une ébauche archivée datant de trois ans et l'autre une directive opérationnelle validée la veille. La recherche vectorielle brute est incapable de prioriser la source légitime.
Règle d'Or en Production :
La recherche vectorielle comprend le sens global, mais la recherche lexicale par mots-clés garantit l'exactitude absolue.
La clé des applications réussies réside dans la fusion de ces deux approches au sein d'un moteur hybride qui filtre et réordonne les passages avant toute soumission au modèle.
2. La Solution Industrielle : RAG Hybride et Reranking Intelligent
Offres Exclusives Tech sur Amazon
Le workshop de Brij Kishore Pandey enseigne méthodiquement comment concevoir un pipeline de recherche hybride de haute performance :
- Recherche Lexicale Avancée : Retrouve avec une précision irréprochable les acronymes, références d'inventaire, codes juridiques et dates clés.
- Recherche Vectorielle Dense : Détecte les synonymes, le contexte sous-jacent et l'intention réelle de l'utilisateur, même si ce dernier n'emploie pas les termes figurant dans la documentation source.
- Fusion Équilibrée des Résultats (RRF) : Un mécanisme transparent qui combine les classements des deux méthodes de recherche, garantissant que les extraits les plus pertinents émergent en tête de sélection.
- Modèle de Reranking Spécialisé : Un modèle léger qui examine simultanément la requête et les extraits pré-identifiés, afin d'établir un ordonnancement de haute fidélité avant la phase de synthèse.
Principe de Fusion Recíproque (RRF) en Termes Simples :
Score de Pertinence = Somme de [ 1 divisé par (60 + Rang dans le Moteur de Recherche) ]
Plus un paragraphe est classé haut à la fois dans la recherche par mots-clés et dans la recherche conceptuelle, plus son score final est élevé et plus vite il est transmis au modèle.
Cette méthode sélective permet de ne transmettre au modèle linguistique que les deux ou trois sections indispensables. Cela diminue la facture d'API de près de 75 % tout en éradiquant les risques d'hallucinations.
3. Intégration Robuste d'Outils et Maîtrise de la Mémoire
Isolé de l'infrastructure de l'entreprise, un modèle de langage reste un simple générateur de texte. Pour délivrer une réelle valeur économique, il doit agir : interroger une base ERP, déclencher une notification client ou orchestrer une mise à jour d'inventaire via des APIs sécurisées.
Durant l'atelier, vous apprendrez à :
- Sécuriser les Appels d'Outils (Tool Calling) : Établir des schémas de données stricts pour empêcher le modèle d'inventer des paramètres ou d'exécuter des actions non autorisées.
- Structurer la Mémoire Court Terme et Long Terme : Différencier l'historique immédiat de la conversation des préférences persistantes et des droits d'accès stockés dans les bases de données.
- Optimiser la Fenêtre de Contexte : Appliquer des techniques de compression intelligente pour préserver la mémoire du système sans faire exploser les dépenses d'inférence.
4. Évaluation Automatisée (Evals) : Passer du Bricolage à la Fiabilité Industrielle
Le principal frein au déploiement des applications IA réside dans l'incertitude : comment s'assurer qu'un changement de prompt ou une mise à jour du modèle ne dégrade pas silencieusement les réponses ?
Vérifier manuellement des milliers d'échanges chaque jour est impensable. La réponse réside dans les cadres d'évaluation automatisés (Evals). Au cours de la formation, vous maîtriserez les indicateurs indispensables :
- Fidélité Factuelle : Mesure automatiquement le pourcentage d'affirmations générées qui sont strictement attestées par les documents d'appui, avec alerte immédiate en cas d'élément inventé.
- Pertinence de la Réponse : Valide que l'agent répond avec exactitude au problème formulé sans digressions superflues.
- Précision du Contexte : Vérifie que la recherche ne surcharge pas l'invite avec du texte inutile, optimisant ainsi les coûts opérationnels.
Critère Stratégique :
Si vous ne mesurez pas la fiabilité de votre application d'IA par des métriques objectives, vous n'avez pas un produit prêt pour vos clients ; vous avez un prototype instable.
5. Cas d'Usage d'Entreprise Concrets Abordés lors de la Masterclass
Brij Kishore Pandey présentera des architectures types directement transposables à vos projets :
- Support Client Technique Automatisé : Conception d'agents capables de résoudre des tickets complexes en consultant la documentation interne sans inventer de garanties commerciales.
- Audit et Analyse de Contrats Réglementaires : Traitement de documents PDF volumineux, extraction rigoureuse de tableaux chiffrés et vérification des clauses de conformité.
- Moteur de Recherche pour Équipes d'Ingénierie : Indexation de bases de code et de documentations d'architecture pour offrir aux développeurs des réponses documentées et sourcées.
6. Un Investissement Professionnel à Fort Rendement
Le marché de l'emploi technologique n'accorde plus de prime aux utilisateurs de prompts de base. Les compétences recherchées et les plus valorisées concernent l'ingénierie de systèmes d'IA robustes, mesurables et connectés.
- Formateur de Renom : Brij Kishore Pandey partage des retours d'expérience concrets issus de déploiements industriels d'envergure.
- Format Interactif en Direct : Échangez en direct avec l'instructeur, posez vos questions techniques et bénéficiez d'un accès durable aux supports et dépôts de code.
- Tarif Partenaire IAExpertos : Profitez de 20 % de réduction avec le code IAEXPERTOS20, soit 172,20 dollars au lieu des 215,25 dollars du tarif officiel.
7. Conclusion et Inscription
Les applications d'intelligence artificielle qui s'imposeront ne seront pas celles qui consomment le plus de ressources, mais celles dont l'architecture logicielle est la plus soignée et la plus rigoureusement évaluée.
Le workshop « Advanced LLM Application Engineering » du 28 novembre est l'opportunité idéale d'acquérir ces méthodes aux côtés d'un expert reconnu. Les places étant limitées pour garantir des échanges interactifs de qualité, réservez dès maintenant votre accès à tarif privilégié.