Español
 English
 Français
 Português
 Deutsch
 Italiano
Come Portare i Modelli di Machine Learning in Produzione Senza Errori: Guida al Workshop di Hadelin de Ponteves
 Generata da IA
Nel panorama tecnologico odierno si registra un paradosso evidente: le aziende investono budget ingenti nell'assunzione di team di data science per sviluppare modelli di Machine Learning all'avanguardia, eppure oltre l'80% di tali modelli non raggiunge mai lo stadio della produzione reale. E persino tra i rari sistemi che completano il rilascio, più della metà subisce cali prestazionali silenziosi, crolli di accuratezza e incrementi incontrollati dei costi di gestione cloud già nelle prime settimane di operatività.
La radice di questo problema non risiede nella formulazione matematica degli algoritmi, bensì nella frattura strutturale tra la sperimentazione in laboratorio (su singoli notebook Jupyter) e i vincoli ingegneristici di un software aziendale mission-critical, chiamato a soddisfare migliaia di richieste concorrenti al secondo nel rispetto di rigidi accordi sui livelli di servizio (SLA).
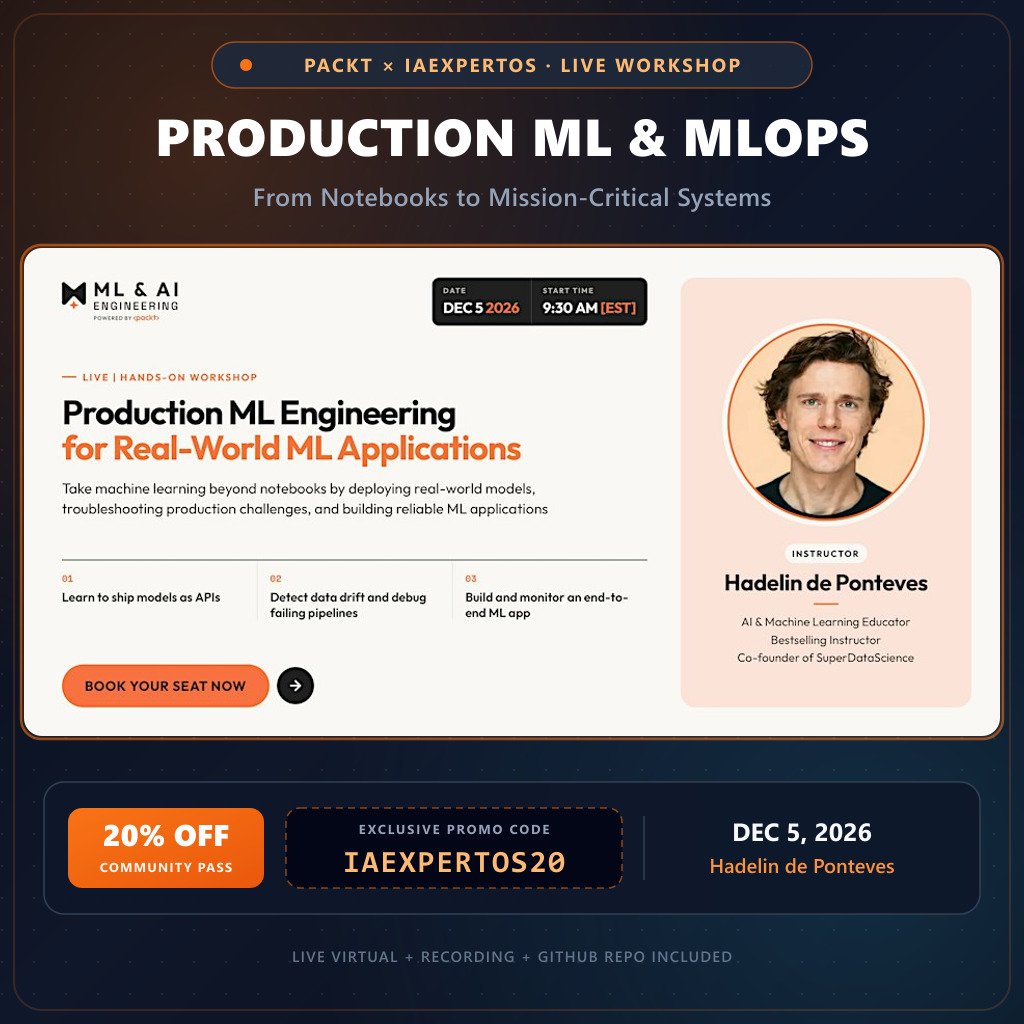
Per superare definitivamente questo ostacolo e formare i professionisti destinati a guidare il settore, la prestigiosa casa editrice Packt promuove per il 5 dicembre 2026 la masterclass tecnica interattiva in streaming: "Production ML Engineering for Real-World ML Applications", tenuta da Hadelin de Ponteves, tra i più influenti divulgatori globali nell'insegnamento applicato dell'intelligenza artificiale, con oltre 2,5 milioni di ingegneri formati nel mondo.
In aggiunta, per tutta la community di IAExpertos è riservato un vantaggio esclusivo: il 20% di sconto diretto inserendo il codice promozionale IAEXPERTOS20, riducendo la quota ufficiale di iscrizione su Eventbrite da 215,25 dollari a soli 172,20 dollari.
In questo approfondimento esaminiamo in maniera chiara, pragmatica e priva di tecnicismi superflui i pilastri formativi del corso, evidenziando perché dominare queste competenze sia indispensabile per ogni ingegnere del software o data scientist.
1. Il Debito Tecnico Nascosto: Perché un Notebook Non È un Prodotto Software
Quando un team di data science consegue un'accuratezza del 95% sui dati storici di addestramento, il vero lavoro ingegneristico è appena agli inizi. Come dimostrato da Google in celebri ricerche sul debito tecnico nel Machine Learning, il codice proprio del modello costituisce meno del 5% del sistema finale. Il restante 95% è rappresentato dall'infrastruttura di supporto:
- Incompatibilità di Ambienti e Librerie: Configurazioni che operano senza intoppi sulla macchina dello sviluppatore generano frequentemente conflitti critici una volta trasferite sui cluster cloud.
- Divergenza fra Training e Produzione (Skew): I passaggi di pulizia e preparazione dei dati storici differiscono spesso dalle modalità con cui i flussi di dati reali giungono dalle applicazioni web o mobile, determinando inferenze fallaci fin dal primo giorno.
- Limiti del Monitoraggio Convenzionale: Gli allarmi di sistema tradizionali (come l'uso di memoria o i controlli HTTP 200) non rilevano se il modello inizia a generare previsioni assurde a causa del mutamento delle abitudini degli utenti.
Regola Aurea in Produzione:
Un modello che risponde in pochi millisecondi ma formula previsioni errate è infinitamente più rischioso di un server inaccessibile, poiché induce l'azienda ad assumere decisioni strategiche sbagliate nell'assoluta inconsapevolezza generale.
2. Le Minacce Silenziose: Data Drift e Concept Drift Spiegati con Semplicità
Offerte Esclusive Tech su Amazon
Gli algoritmi non si usurano fisicamente, ma degradano inesorabilmente a causa delle continue trasformazioni dell'ambiente operativo:
- Deriva dei Dati (Data Drift): Si manifesta quando muta la distribuzione statistica della popolazione esaminata. Ad esempio, se un modello di credit scoring è stato addestrato in un periodo con tassi d'interesse all'1%, e lo scenario macroeconomico sale al 5%, i parametri in ingresso risulteranno del tutto inediti rispetto a quanto appreso dall'algoritmo.
- Deriva del Concetto (Concept Drift): Avviene quando cambiano le relazioni intrinseche tra variabili e comportamenti umani. Durante fasi di shock economico, le propensioni di spesa possono ribaltarsi in pochi giorni; un modello predittivo fondato sulle vendite dell'anno precedente risulterà immediatamente inattendibile.
Formula Intuitiva dell'Indice di Stabilità della Popolazione (PSI):
Indice di Rischio = Somma di [ (Percentuale Attuale - Percentuale Storica) x Differenza Logaritmica ]
In termini chiari e operativi:
- Se il punteggio è inferiore a 0,10, il comportamento del pubblico è stabile e il modello è in sicurezza.
- Tra 0,10 e 0,25, emergono variazioni moderate che consigliano un controllo approfondito.
- Oltre 0,25, si registra una deriva critica che richiede un riaddestramento tempestivo o il passaggio a regole di salvaguardia.
Durante il workshop con Hadelin de Ponteves imparerai a configurare cruscotti di controllo automatici capaci di monitorare questi indici in tempo reale, consentendoti di intervenire prima che le anomalie si traducano in danni economici.
3. Strategie di Rilascio Protette: Addio ai Deploy Rischiosi
Nel software tradizionale, l'aggiornamento di una release è una procedura collaudata. Nel Machine Learning, sostituire improvvisamente un modello operativo con una nuova versione su tutto il traffico live rappresenta un azzardo ingiustificato.
Nella masterclass approfondirai le due metodologie di rilascio adottate dalle aziende tecnologiche più avanzate:
- Shadow Deployment: Il modello candidato riceve in background una copia di tutte le richieste in ingresso; le sue predizioni vengono archiviate internamente per analisi comparative, senza essere inviate agli utenti. Questo permette di testarne latenza e precisione sotto carico reale a rischio zero.
- Canary Release Progressiva: Una volta validato in modalità shadow, al nuovo modello viene instradata una percentuale minima del traffico reale (1%-5%). Se i riscontri qualitativi risultano ottimali, la quota viene gradualmente estesa al 25%, al 50% fino alla transizione totale.
Salvaguardia Architetturale Indispensabile:
Ogni architettura di produzione deve incorporare un interruttore di sicurezza (Circuit Breaker) in grado di reindirizzare istantaneamente il traffico sulla versione precedente a fronte di anomalie o ritardi anomali.
4. Riaddestramento Continuo e Scenari Reali di Business
Ritenere che un modello rimanga immutato dopo la prima fase di addestramento è un grave errore di prospettiva. Il valore di un ingegnere specializzato in MLOps si misura nella capacità di strutturare pipeline di riaddestramento continuo:
- E-Commerce e Raccomandazione: Aggiornare cataloghi e cluster di preferenza in tempo reale per sostenere le conversioni senza sovraccaricare l'infrastruttura computazionale.
- Antifrode Bancaria e Finanziaria: Adattare costantemente i modelli predittivi all'evoluzione delle dinamiche fraudolente, riducendo i falsi allarmi a carico della clientela legittima.
- Manutenzione Predittiva Industriale: Analizzare i dati provenienti dai sensori degli impianti per prevenire avarie meccaniche e pianificare i fermi tecnici in modo proattivo.
5. Considerazioni Strategiche e di Governance per IT Manager e CTO
Per le figure decisionali in ambito IT, la gestione dei modelli in produzione richiede una visione olistica orientata al controllo dei rischi operativi e all'efficienza degli investimenti:
- Ottimizzazione dei Costi Cloud e Dimensionamento Dinamico: L'introduzione di procedure di quantizzazione e caching intelligente consente di abbattere fino al 50% i costi computazionali mantenendo latenze di risposta inferiori a 20 millisecondi.
- Tracciabilità e Requisiti di Conformità: L'adozione di registri unificati per feature e modelli assicura che qualsiasi decisione algoritmica passata possa essere auditata e ricollegata con precisione all'esatto dataset e alla specifica configurazione di addestramento.
- Disaccoppiamento per Rilasci Senza Disservizi: L'adozione di protocolli di comunicazione standardizzati tra l'infrastruttura di scoring e i servizi applicativi permette di aggiornare i modelli senza interrompere l'operatività degli utenti finali.
Questo approccio metodologico tutela il patrimonio informativo aziendale e mette l'organizzazione al riparo da obsolescenze precoci.
6. Perché Partecipare al Workshop con Hadelin de Ponteves Rappresenta una Scelta di Valore
Cofondatore di Bluelife AI, Hadelin de Ponteves ha supportato multinazionali di primo piano nell'integrazione di sistemi di intelligenza artificiale avanzati.
- Didattica Pragmatica ed Efficace: Hadelin si distingue per l'abilità di rendere accessibili concetti complessi, traducendoli in modelli di ingegneria del software pronti per l'adozione aziendale.
- Confronto Diretto ed Esercitazioni: Avrai l'opportunità di porre quesiti specifici sulle problematiche della tua azienda e manterrai l'accesso illimitato a tutti i repository di codice del corso.
- Tariffa Esclusiva IAExpertos: Con il codice promozionale IAEXPERTOS20 risparmi 43,05 dollari rispetto alla quota di listino, accedendo al corso a soli 172,20 dollari anziché 215,25 dollari.
7. Conclusioni e Iscrizione Ufficiale
Il futuro dell'intelligenza artificiale nelle imprese appartiene agli ingegneri in grado di garantire che i modelli operino in modo stabile, sicuro ed economicamente sostenibile ogni giorno.
La masterclass "Production ML Engineering for Real-World ML Applications" del 5 dicembre costituisce il percorso più efficace per padroneggiare queste competenze. I posti per la trasmissione live sono limitati per assicurare un'adeguata interazione. Assicurati la tua partecipazione approfittando subito del 20% di sconto riservato.